研究
Gwenlake は学術研究から生まれ、研究をやめたことはありません。顧客プロジェクトと並行して、チームは常に自らの研究プロジェクトに取り組み、その一部は今も大学で教え、論文を発表しています。ここに集まるのはその成果です。ブラウザで試せるプロトタイプと、オープンソースとして公開しているコードです。
小さなモデル、 transformer、強化学習……そしてゲーム!
どのプロジェクトでも出会う問いがあります。明確に定義され、百万回実行されるタスクに対して、大きな汎用モデルを使ってタスクをその言葉で記述するのか、それともタスク自体の構造に合わせて小さなモデルを作るのか。
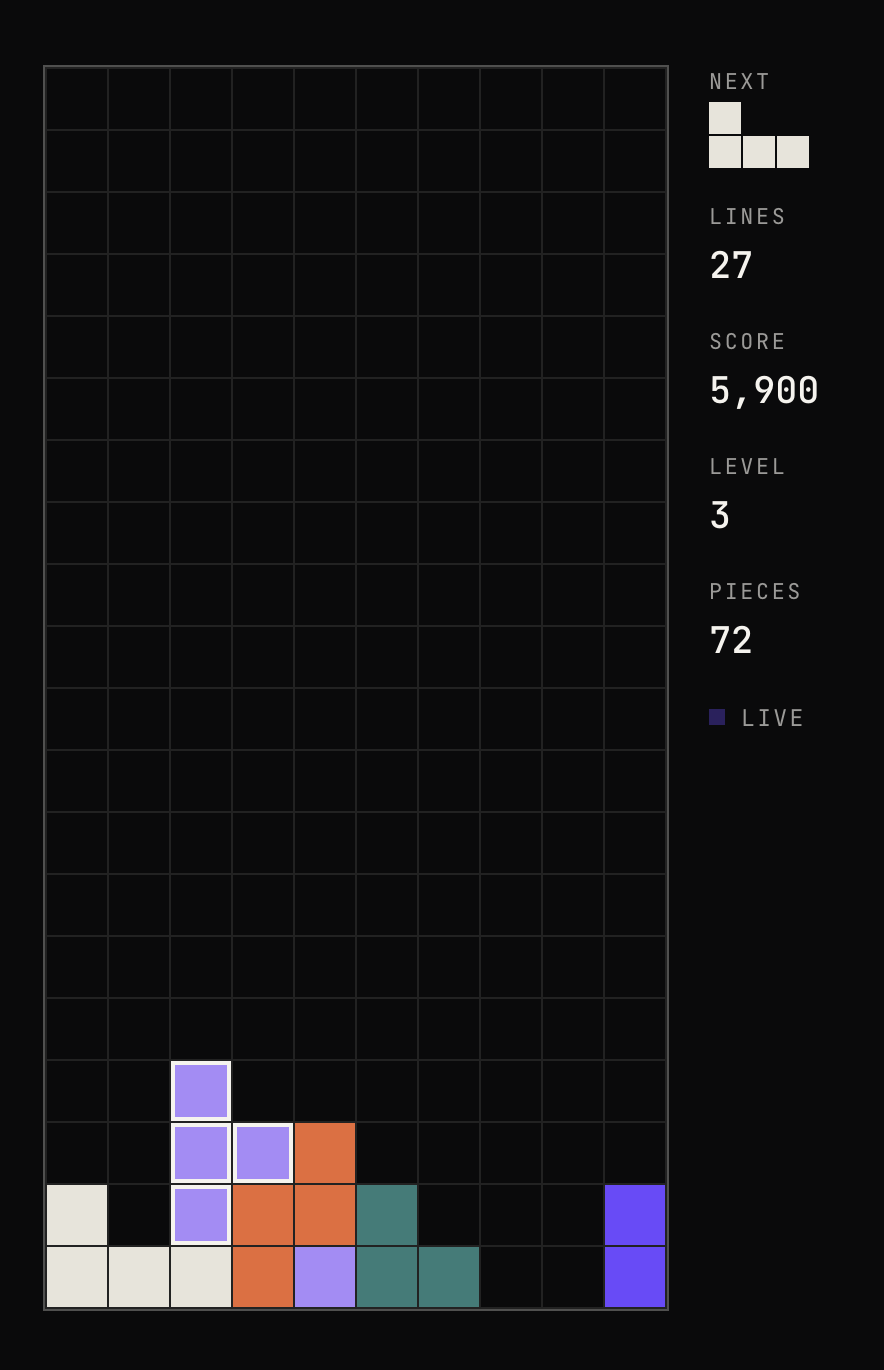
私たちはこの問いを、スコアに議論の余地がない二つのゲーム、テトリスとチェスで検証しました。
Gwenflow、私たちのエージェント型 AI フレームワーク
Gwenflow は AI エージェントを動かします。目標、ツール、記憶、モデルを与えると、エージェントは推論し、行動し、観察し、目標が達成されるまでこれを繰り返します。私たちが構築するすべてのエージェントシステムの基盤となる SDK であり、エージェントが実行するコードを一行残らず把握するために自分たちで書きました。
- Python
- MIT ライセンス
- pip install gwenflow
from gwenflow import Agent, ChatMistralfrom gwenflow.tools import Tool def accounts_at_risk(period: str, min_drop: int = 10) -> list[dict]: """Accounts whose usage fell by at least `min_drop` percent.""" return crm.query(period=period, trend="down", min_drop=min_drop) agent = Agent( name="Account review", instructions="Rank the accounts at risk, with the figures.", llm=ChatMistral(), tools=[Tool(accounts_at_risk)],) response = agent.run("Which accounts are at risk this quarter?")どのモデルでも、一つの API で
OpenAI、Anthropic、Mistral、Google、DeepSeek、ローカルの Ollama、あるいは私たちの API。import を一つ変えれば提供元が切り替わり、エージェントのコードはそのままです。推論、ストリーミング、画像・音声・PDF の入力も同じ経路で扱えます。
エージェント、ツール、チーム
エージェントはループを回します。モデルを呼び、ツールを実行し、結果を読み、完了するまで繰り返す。どんな Python 関数もツールになります。専門エージェントのチームを与えれば、エージェントは彼らに委任します。長いパイプラインはコードや YAML で書く DAG です。
本番運用を最初から
Pydantic モデルによる構造化出力、ドキュメントリーダーとベクトルストアを備えた RAG パイプライン、必要なときに読み込まれるスキル、そして標準で有効な OpenTelemetry のトレーシング。
研究用 ライブラリ
より小さく、用途を絞ったものです。いずれも、私たち自身が解く必要のあった問題から生まれました。